 9 ottobre 2026
 8 min lettura
Cos'è Celery Beat e a cosa serve
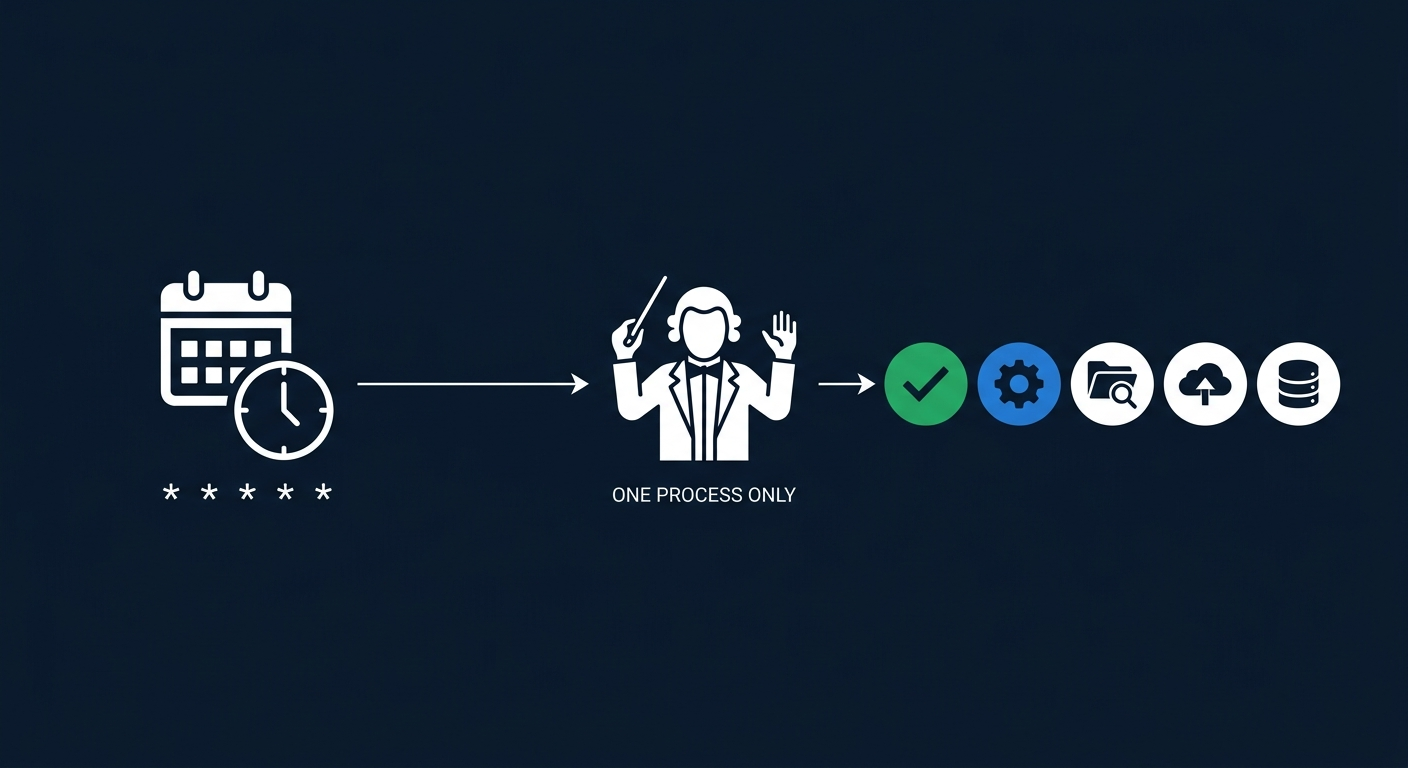
Celery Beat è lo scheduler di Celery — il componente che si occupa di avviare i task Celery in modo periodico, secondo un calendario definito. Se Celery worker esegue i task, Celery Beat decide quando metterli in coda.
Senza Celery Beat, i task Celery vengono eseguiti solo quando qualcosa li chiama esplicitamente — una view, un signal, un management command. Con Celery Beat puoi definire task che girano automaticamente ogni minuto, ogni ora, ogni giorno, o secondo una crontab arbitraria — senza bisogno di un cron di sistema.
I casi d'uso tipici in un'applicazione Django reale:
- Invio di email o notifiche periodiche (report giornalieri, reminder di scadenze)
- Pulizia del database — cancellare record vecchi, sessioni scadute, file temporanei
- Sincronizzazione con sistemi esterni — API, feed RSS, import di dati
- Generazione di statistiche aggregate
- Monitoraggio e health check interni
Celery Beat vs cron di sistema: quando usare l'uno o l'altro
Prima di configurare Celery Beat, vale la pena chiedersi se è davvero lo strumento giusto.
Il cron di sistema è semplice, affidabile, e non richiede nessuna dipendenza aggiuntiva. Per un management command Django che deve girare ogni notte, una riga in crontab è spesso la soluzione più pulita:
0 2 * * * /path/to/venv/bin/python /path/to/manage.py comando_notturnoCelery Beat ha senso quando:
- I task devono girare con frequenza alta (ogni minuto o ogni pochi minuti) — cron ha granularità minima di un minuto e non gestisce bene frequenze elevate
- I task devono essere distribuiti tra più worker — Celery gestisce la distribuzione, cron no
- Vuoi gestire e modificare i task da interfaccia web (Django Admin con django-celery-beat)
- I task fanno parte dello stesso sistema Celery già in uso per i task asincroni
- Hai bisogno di monitorare l'esecuzione dei task con strumenti come Flower o Sentry
Se il tuo caso d'uso è un report notturno o una pulizia settimanale del database, cron è probabilmente sufficiente. Se hai decine di task con frequenze diverse che devono essere monitorati e modificabili senza deploy, Celery Beat è la scelta giusta.
Configurazione base in Django
Installazione:
pip install celery django-celery-beat rediscelery.py nella directory del progetto:
import os
from celery import Celery

os.environ.setdefault("DJANGO_SETTINGS_MODULE", "config.settings")

app = Celery("myproject")
app.config_from_object("django.conf:settings", namespace="CELERY")
app.autodiscover_tasks()settings.py:
INSTALLED_APPS = [
    "django_celery_beat",
]

CELERY_BROKER_URL = os.environ.get("CELERY_BROKER_URL", "redis://localhost:6379/0")
CELERY_RESULT_BACKEND = os.environ.get("CELERY_RESULT_BACKEND", "redis://localhost:6379/0")
CELERY_TIMEZONE = "Europe/Rome"
CELERY_BEAT_SCHEDULER = "django_celery_beat.schedulers:DatabaseScheduler"

CELERY_BEAT_SCHEDULE = {
    "pulizia-sessioni-scadute": {
        "task": "myapp.tasks.pulisci_sessioni_scadute",
        "schedule": crontab(hour=3, minute=0),
    },
    "report-giornaliero": {
        "task": "myapp.tasks.invia_report_giornaliero",
        "schedule": crontab(hour=8, minute=0, day_of_week="mon-fri"),
    },
}
CELERY_BEAT_SCHEDULER = "django_celery_beat.schedulers:DatabaseScheduler" è la differenza chiave rispetto alla configurazione base — salva i task nel database Django invece che in un file locale. Questo permette di modificarli da Django Admin senza riavviare il servizio.
Dopo migrate, i task definiti in CELERY_BEAT_SCHEDULE vengono automaticamente creati nel database.
I problemi reali in produzione — e come evitarli
Task duplicati: il problema più comune
Se avvii più istanze di Celery Beat contemporaneamente — per errore, per un deploy mal gestito, o perché il container precedente non si è fermato prima che partisse quello nuovo — ogni istanza metterà in coda lo stesso task alla stessa ora. Il risultato sono task eseguiti due volte, con effetti che dipendono da cosa fa il task: email duplicate, record creati due volte, contatori sbagliati.
Regola fondamentale: deve girare una sola istanza di Celery Beat alla volta.
In Docker Compose è semplice garantirlo con un container dedicato:
celery-beat:
  image: myapp:latest
  command: celery -A config beat -l info --scheduler django_celery_beat.schedulers:DatabaseScheduler
  depends_on:
    - redis
    - db
  restart: unless-stopped
Il restart: unless-stopped garantisce che il container riparta in caso di crash, ma non ne avvia mai due in parallelo.
Timezone: la trappola silenziosa
CELERY_TIMEZONE = "Europe/Rome" non basta da solo. Se il server gira in UTC — come quasi tutti i server Linux e i container Docker — e non hai configurato correttamente la timezone, i task gireranno all'ora sbagliata. Un task schedulato alle 8:00 ora italiana girerà alle 7:00 UTC in inverno e alle 6:00 UTC in estate.
Verifica sempre aggiungendo anche:
CELERY_ENABLE_UTC = True
USE_TZ = True
TIME_ZONE = "Europe/Rome"
Con CELERY_ENABLE_UTC = True e CELERY_TIMEZONE impostato, Celery converte automaticamente le ore della crontab nella timezone specificata.
Il file di schedule: da non usare in produzione
Il scheduler di default di Celery (senza django-celery-beat) salva lo stato dei task in un file celerybeat-schedule nella directory corrente. In un ambiente containerizzato questo file viene perso ad ogni restart del container — con il risultato che Celery Beat non ricorda quali task ha già eseguito e li riesegue tutti all'avvio.
django-celery-beat con DatabaseScheduler risolve questo usando il database Django come storage persistente — il giusto posto per dati che devono sopravvivere ai restart dei container.
Task che non terminano
Se un task periodico richiede più tempo del suo intervallo di schedulazione — un task schedulato ogni 5 minuti che a volte impiega 10 minuti — possono accumularsi task in esecuzione contemporanea sullo stesso worker.
La soluzione è impostare un timeout e usare i task con acks_late=True per evitare che un task bloccato occupi il worker indefinitamente:
@shared_task(bind=True, time_limit=240, soft_time_limit=200, acks_late=True)
def task_con_timeout(self):
    try:
        esegui_operazione()
    except SoftTimeLimitExceeded:
        logger.warning("Task interrotto per timeout")
soft_time_limit solleva un'eccezione gestibile, time_limit termina forzatamente il task dopo il tempo specificato.
Gestire i task da Django Admin
Con django-celery-beat installato, Django Admin include una sezione "Periodic Tasks" che permette di:
- Aggiungere, modificare e disabilitare task senza toccare il codice
- Cambiare la crontab di un task senza deploy
- Vedere l'ultima volta che un task è stato eseguito
- Abilitare e disabilitare singoli task in tempo reale
Questo è uno dei vantaggi principali rispetto a cron di sistema — la gestione operativa dei task è visibile e modificabile da chiunque abbia accesso all'admin, senza SSH e senza toccare file di configurazione.
Monitoraggio: sapere quando un task non gira
Celery Beat non notifica quando un task fallisce o non gira — si limita a metterlo in coda. Il monitoraggio dell'esecuzione è responsabilità del worker e del sistema di logging.
Per sapere quando un task non si è eseguito all'ora prevista, ci sono due approcci:
Sentry con Crons — Sentry ha una funzionalità specifica per monitorare i cronjob. Ogni task registra un "check-in" all'inizio e alla fine dell'esecuzione. Se Sentry non riceve il check-in entro la finestra temporale prevista, invia un alert.
import sentry_sdk

@shared_task
def report_giornaliero():
    with sentry_sdk.monitor(monitor_slug="report-giornaliero"):
        genera_e_invia_report()
Logging strutturato — come minimo, ogni task periodico dovrebbe loggare inizio, fine, e risultato. Con un aggregatore di log puoi costruire alert su pattern di fallimento.
In Skara uso entrambi: Sentry Crons per i task critici (generazione documenti, notifiche), logging per tutti gli altri.
Avviare Celery Beat in produzione
Con Docker Compose, la configurazione completa per worker e beat separati:
celery-worker:
  image: myapp:latest
  command: celery -A config worker -l info -c 4
  depends_on:
    - redis
    - db
  restart: unless-stopped

celery-beat:
  image: myapp:latest
  command: celery -A config beat -l info --scheduler django_celery_beat.schedulers:DatabaseScheduler
  depends_on:
    - redis
    - db
  restart: unless-stopped
Worker e beat sono container separati — il beat non esegue task, li mette solo in coda. I worker li eseguono. Questa separazione permette di scalare i worker indipendentemente dal beat, e garantisce che ci sia sempre e solo un processo beat attivo.